Cargando...
Artículos sobre MoE
Artículos relacionados con MoE en Blogia.
14 artículos
NoticiasQwen3.8AlibabaQwen
Qwen3.8-Max-Preview ya está disponible: el flagship de 2.4T parámetros de Alibaba llega al frontier (guía completa)
Alibaba lanzó Qwen3.8-Max-Preview el 19 de julio de 2026: 2.4T parámetros MoE, contexto de 1M, multimodal nativo, thinking mode y compatible con APIs OpenAI y Anthropic. Segundo solo a Claude Fable 5 según Alibaba. Acceso, precios, specs y análisis crítico.
23 de julio de 2026
NoticiasThinking MachinesInklingMira Murati
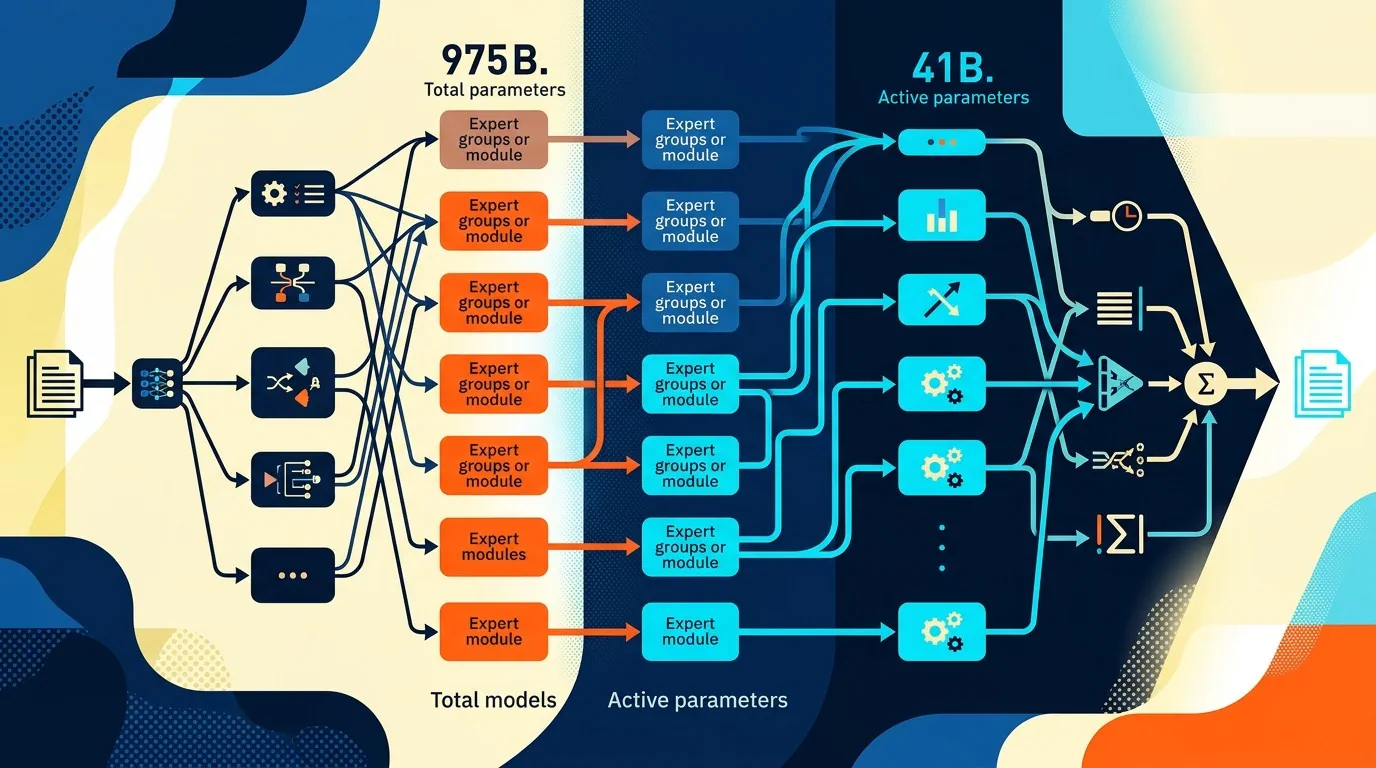
Inkling de Thinking Machines: el primer modelo open-weights frontier de EE.UU. con 975B parámetros
Thinking Machines Lab, fundada por Mira Murati (ex-CTO de OpenAI), lanza Inkling: 975B parámetros MoE, multimodal (texto/imagen/audio), contexto 1M, licencia Apache 2.0. El modelo open-weights más potente de EE.UU. Inkling-Small (276B) en preview.
17 de julio de 2026
NoticiasKimi K3Moonshot AIcódigo abierto
Moonshot AI lanza Kimi K3: el modelo open source más grande del mundo con 2.8T parámetros y 1M de contexto
Kimi K3 de Moonshot AI es el modelo open source más grande jamás lanzado: 2.8T parámetros MoE, contexto de 1M de tokens, dos variantes (K3 Max y K3 Swarm Max) y arquitectura nueva. Disponible ya en kimi.com. Pesos abiertos el 27 de julio.
16 de julio de 2026
GuíasNex-N2-ProIAcódigo abierto
Nex-N2-Pro: la guía completa del modelo agéntico de código abierto
Qué es Nex-N2-Pro, características clave, benchmarks, precios, cómo usarlo vía API y despliegue local, y comparativa con GPT-5.5, Claude Opus 4.7 y DeepSeek-V4-Pro.
14 de julio de 2026
NoticiasDeepSeek V4DeepSeek V4-ProDeepSeek V4-Flash
DeepSeek V4: el modelo open source más barato del mercado con 1M de contexto (2026)
DeepSeek V4 Pro y Flash: modelos open source MIT con 1M contexto. V4-Pro 1.6T MoE a $0.44/$0.87 por 1M tokens, el más barato del mercado. Arquitectura, benchmarks, pricing peak/off-peak y migración. Julio 2026.
10 de julio de 2026